阿里:SWE-CI评估Agent在持续集成中的代码维护能力
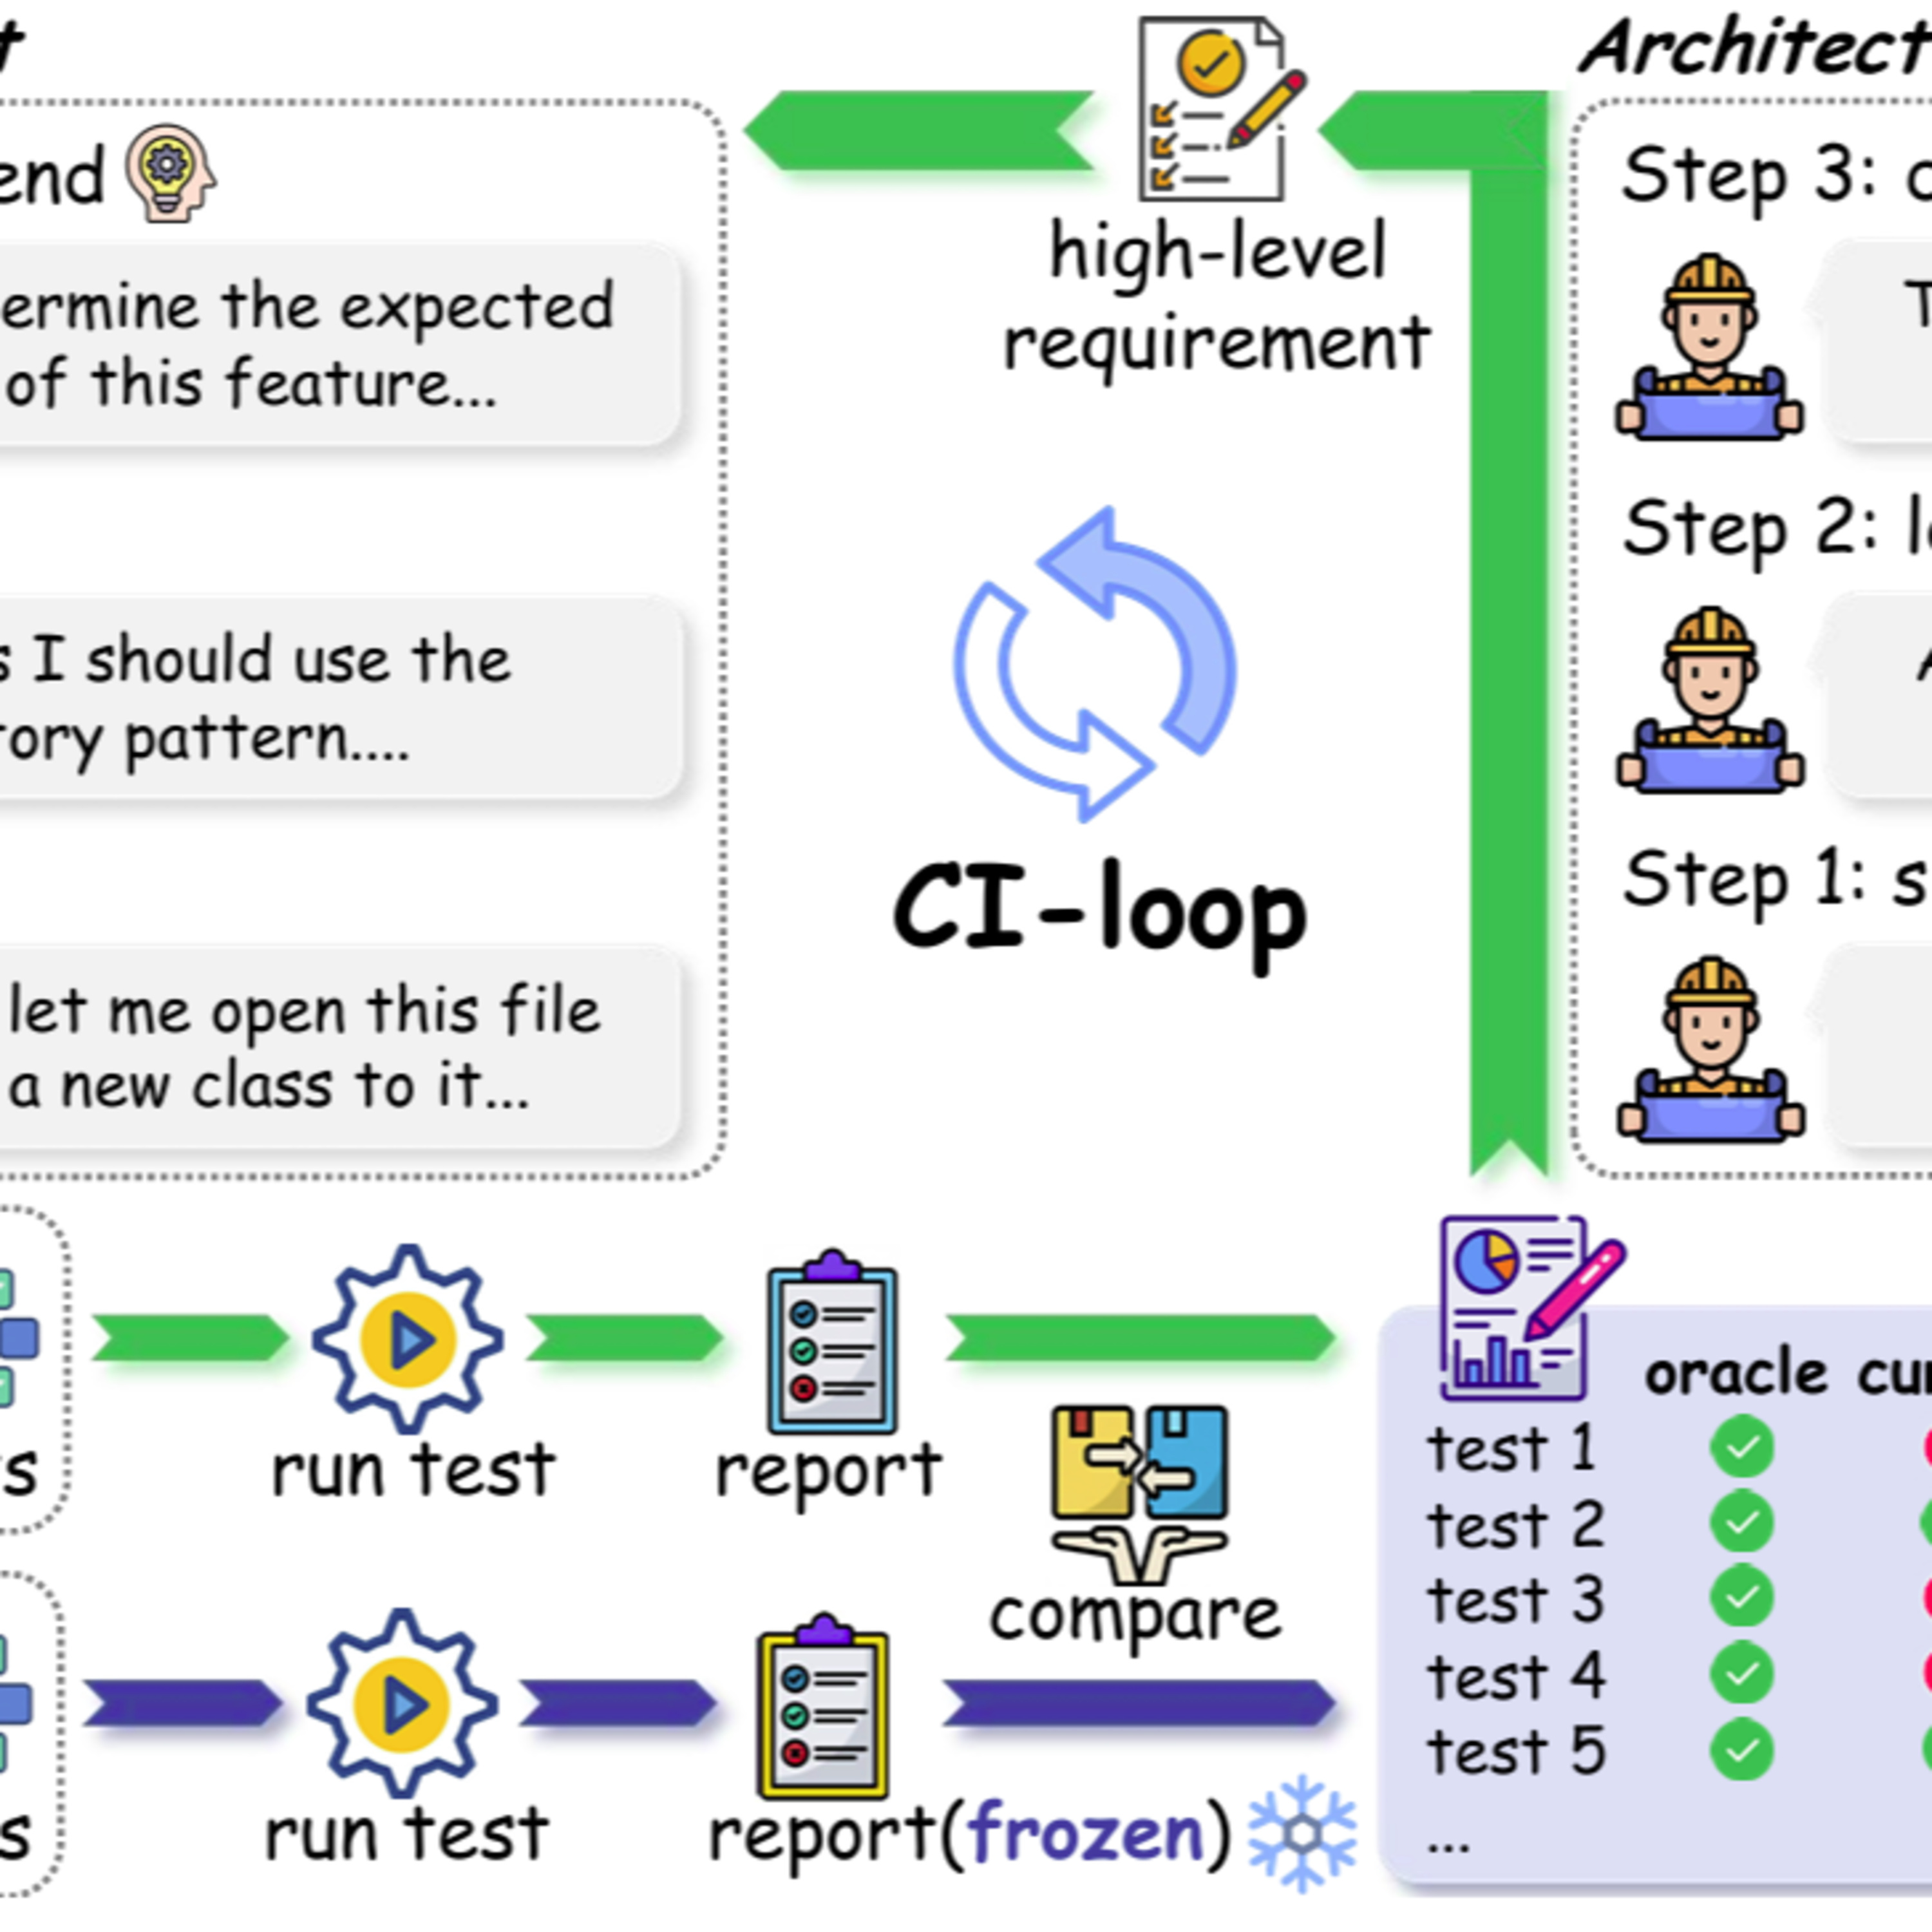
SWE-CI 是一个针对大语言模型(LLM)智能体设计的创新型基准测试,旨在评估其在真实场景下的长期代码维护能力。与传统的单次静态修复测试不同,该研究通过模拟持续集成(CI)循环,要求由“架构师”和“程序员”组成的双智能体系统协同处理复杂的代码演进任务。该基准包含来自真实 GitHub 仓库的 100 个任务,平均每个任务涵盖长达 233 天的开发历史。研究引入了 EvoScore 指标,通过衡量模型在多次迭代中避免回归错误和保持代码质量的表现,反映了模型对技术债务的控制能力。实验结果显示,尽管目前的模型在功能实现上有所进步,但在应对长期软件演进挑战时仍面临显著困难。
The skinny
The skinny isn't ready yet — notes appear once the transcript is processed.