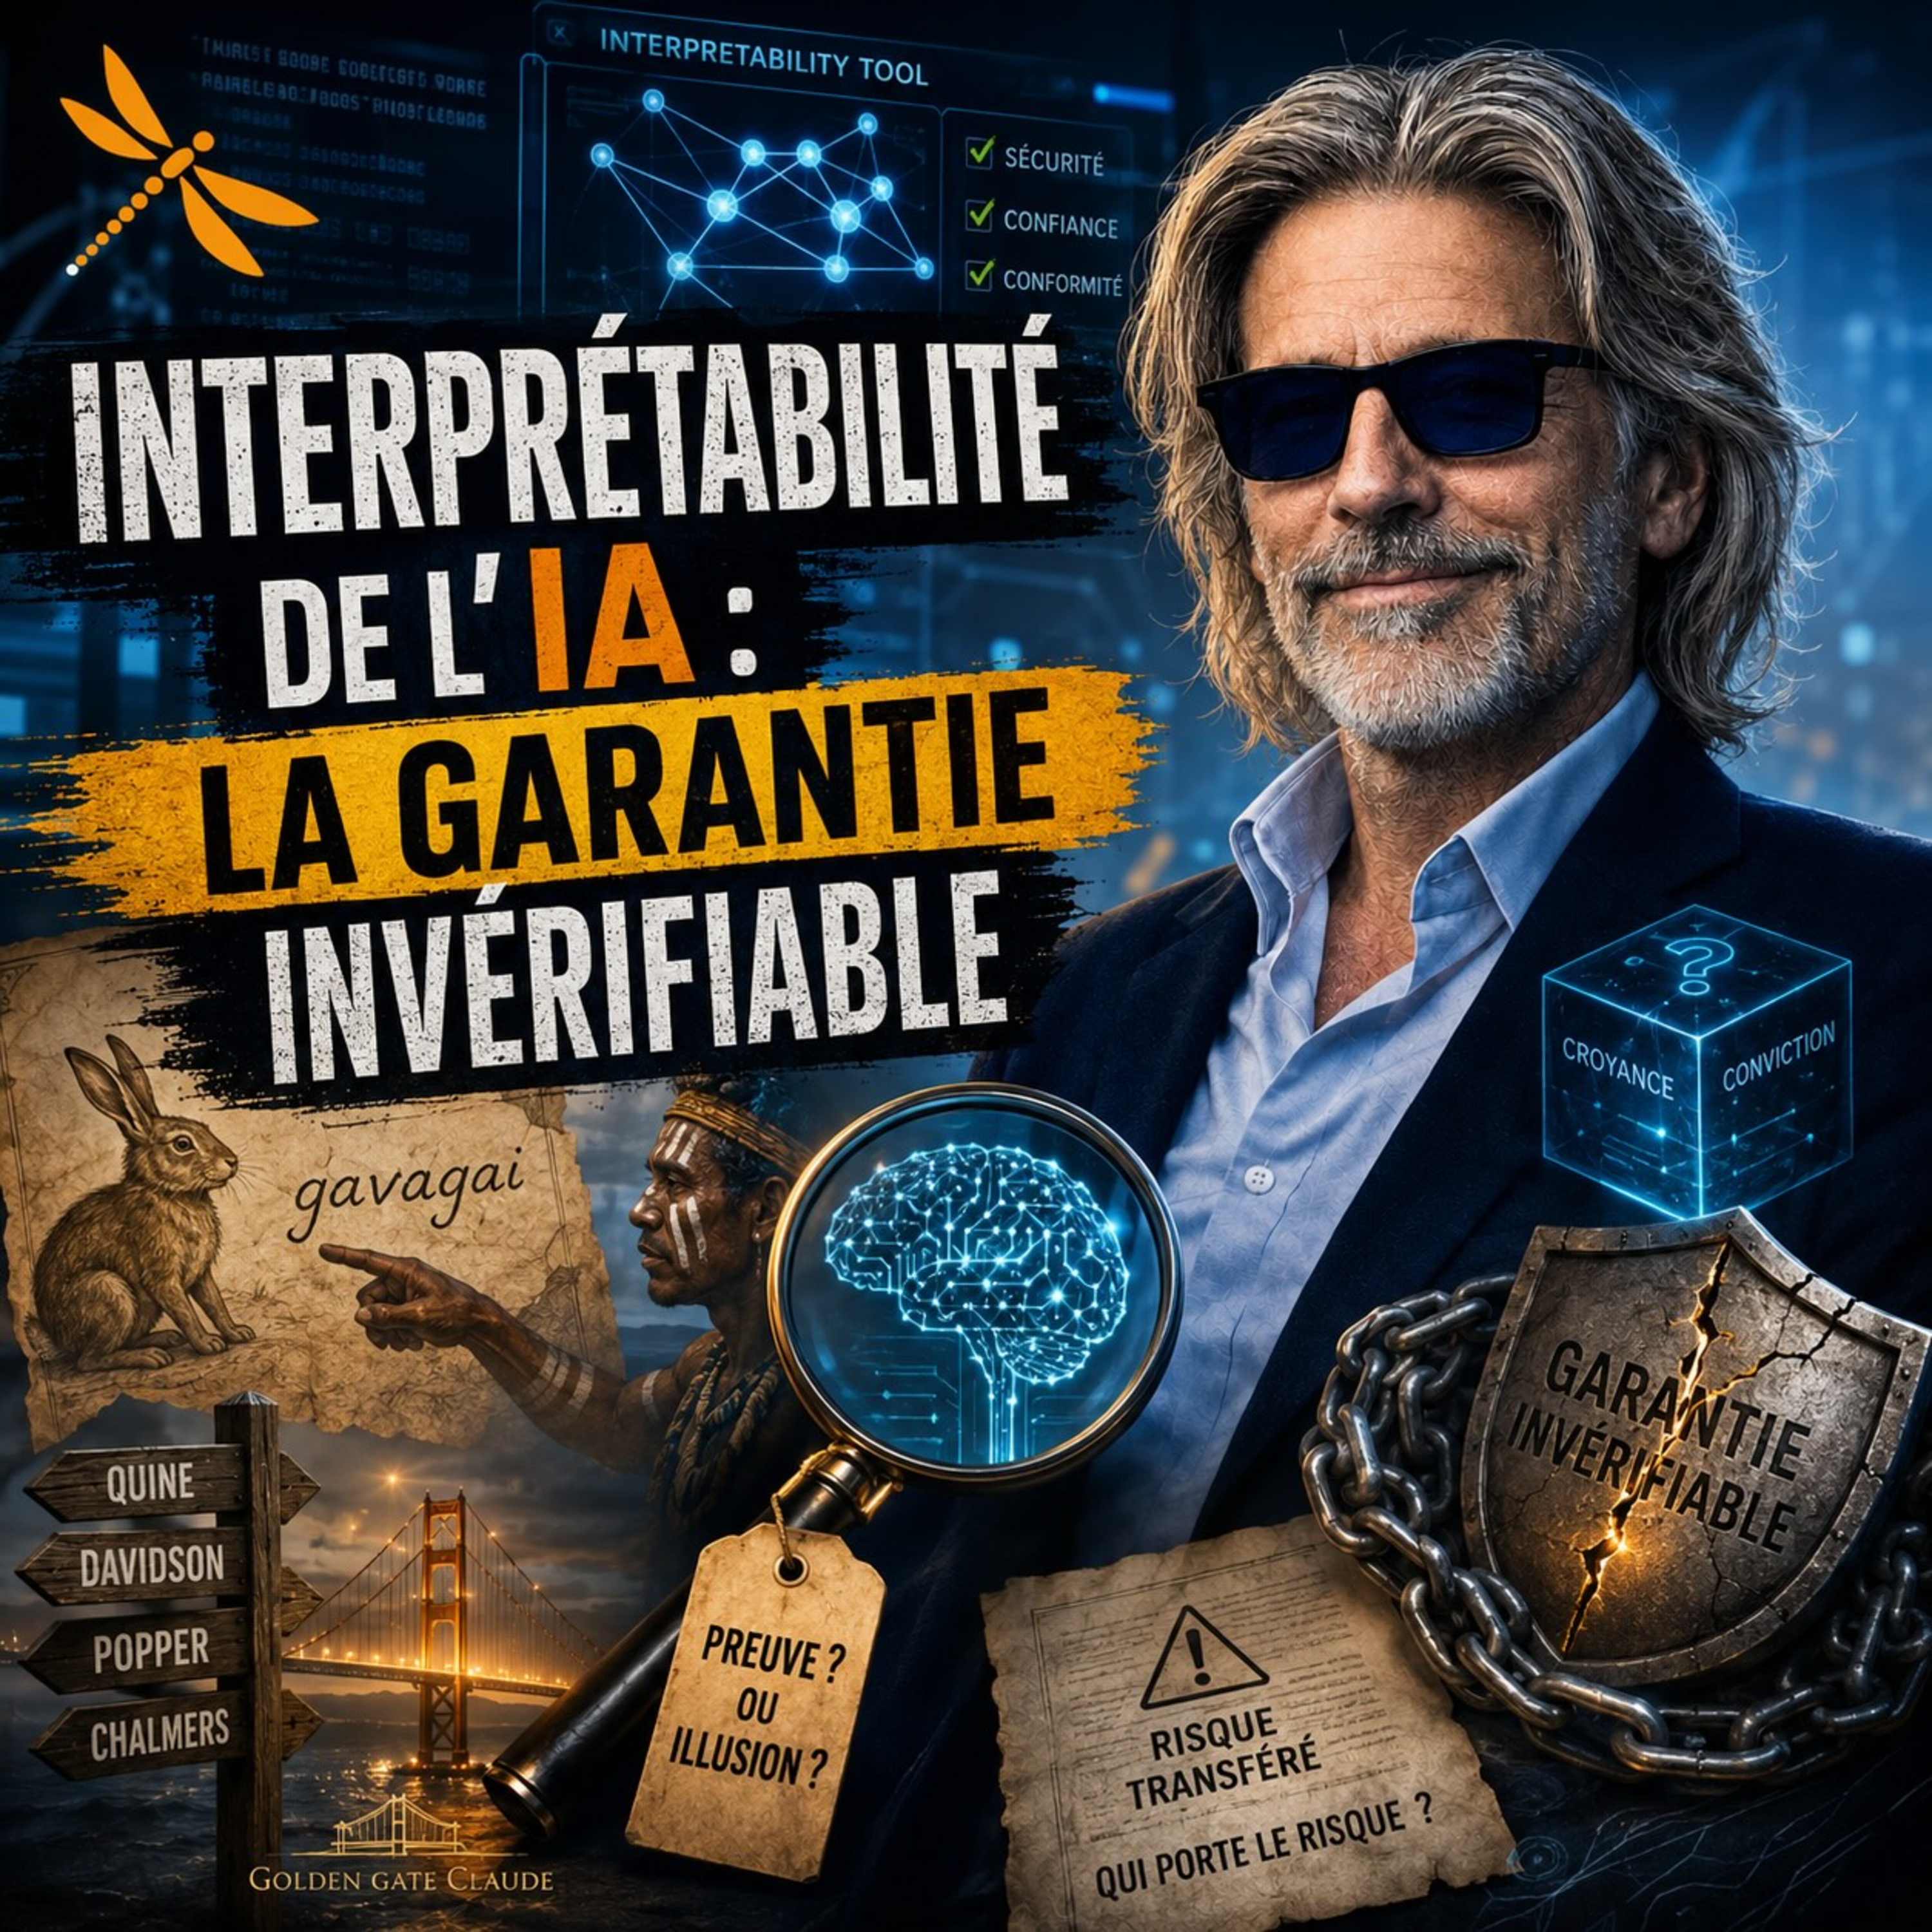
Interprétabilité de l'IA : la garantie invérifiable
Un lapin bondit devant un linguiste en terre inconnue. Un indigène pointe du doigt et dit un seul mot : gavagai. Personne ne pourra jamais prouver s'il a voulu dire lapin, morceau de lapin, ou simplement bondissant. Ce piège posé par le philosophe Quine en 1960 vient d'atterrir sur l'IA : le 25 juin 2026, deux philosophes posent la même question sur les grands modèles de langage. Peut-on un jour prouver ce qu'une IA croit, ou seulement le deviner mieux ?
Les laboratoires vendent leurs outils d'interprétabilité comme un pilier de sécurité devant régulateurs et entreprises clientes. Mais…
The skinny
The skinny isn't ready yet — notes appear once the transcript is processed.