【第509期】GDPO:多奖励强化学习的解耦归一化策略优化
Seventy3:借助NotebookLM的能力进行论文解读,专注人工智能、大模型、机器人算法、crypto方向,让大家跟着AI一起进步。
如果你有自己的论文要解读,或者推荐论文,请留言。
今天的主题是:
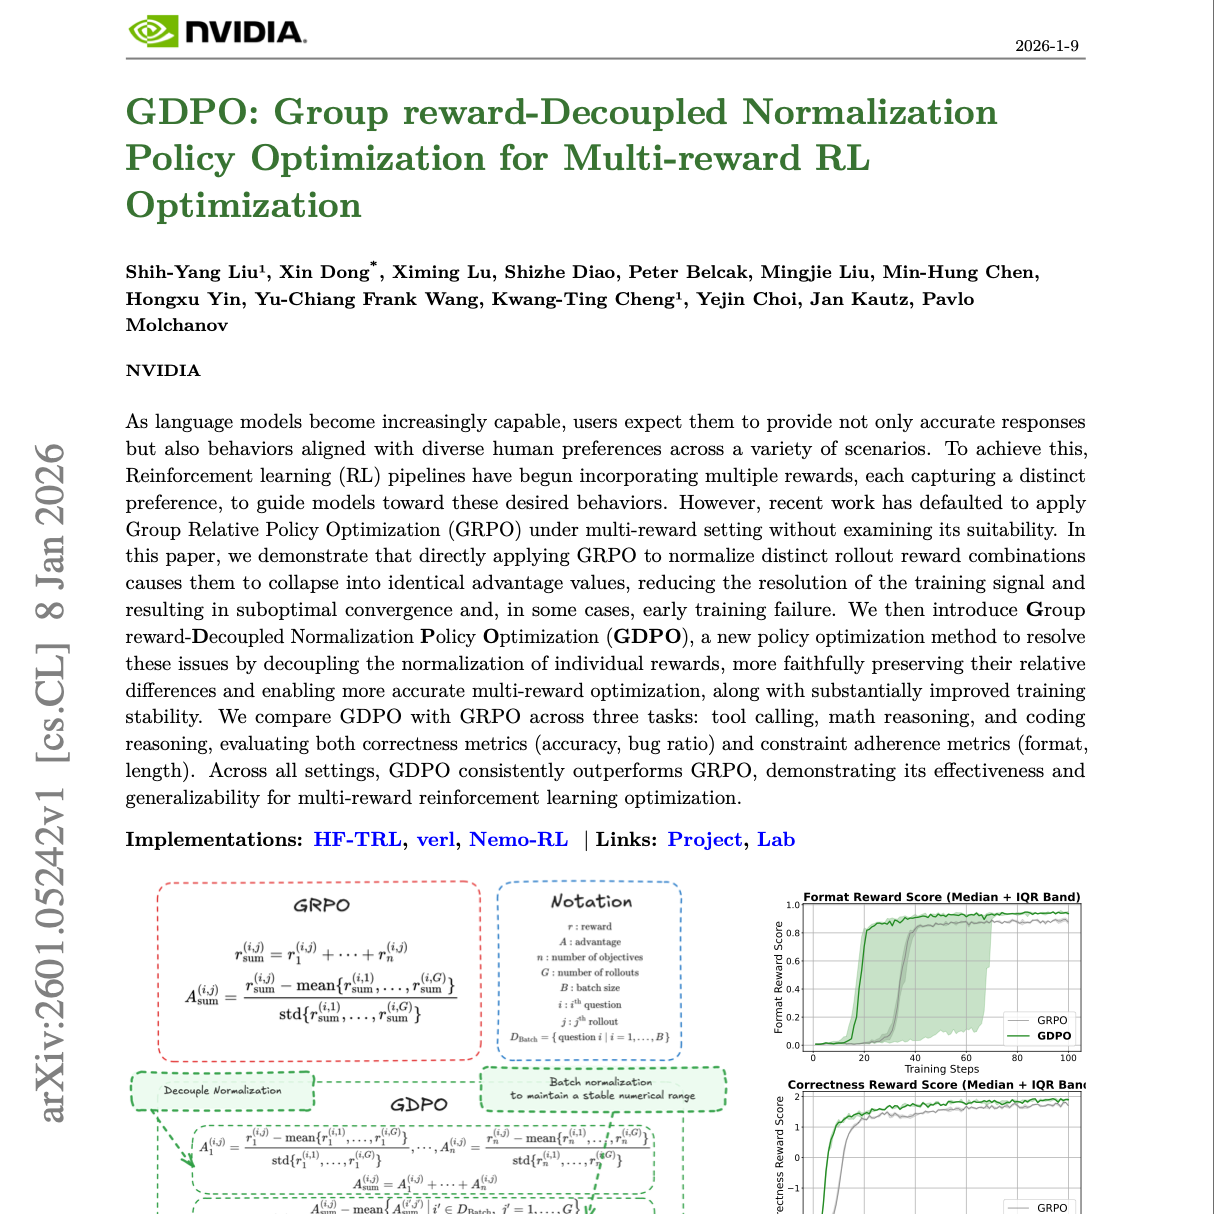
GDPO: Group reward-Decoupled Normalization Policy Optimization for Multi-reward RL Optimization
Summary
随着语言模型能力的不断提升,用户不仅期望其提供准确的回答,还希望其行为能够在多种场景下符合多样化的人类偏好。为实现这一目标,强化学习(RL)流程开始引入多个奖励信号,每个奖励分别刻画一种不同的偏好,以引导模型朝着期望行为优化。然而,近期研究在多奖励设定下默认采用 Group Relative Policy Optimization(GRPO),却未对其适用性进行充分检验。
本文表明,直接在多奖励场景中应用 GRPO,对不同 rollout 奖励组合进行归一化时,会导致这些组合坍缩为相同的优势值(advantage value),从而降低训练信号的分辨率,导致次优收敛,甚至在某些情况下出现训练早期失败。
为解决上述问题,我们提出了 Group reward-Decoupled Normalization Policy…
The skinny
The skinny isn't ready yet — notes appear once the transcript is processed.