【第479期】AlphaProof:深度强化学习形式化数学证明
Seventy3:借助NotebookLM的能力进行论文解读,专注人工智能、大模型、机器人算法、crypto方向,让大家跟着AI一起进步。
今天的主题是:
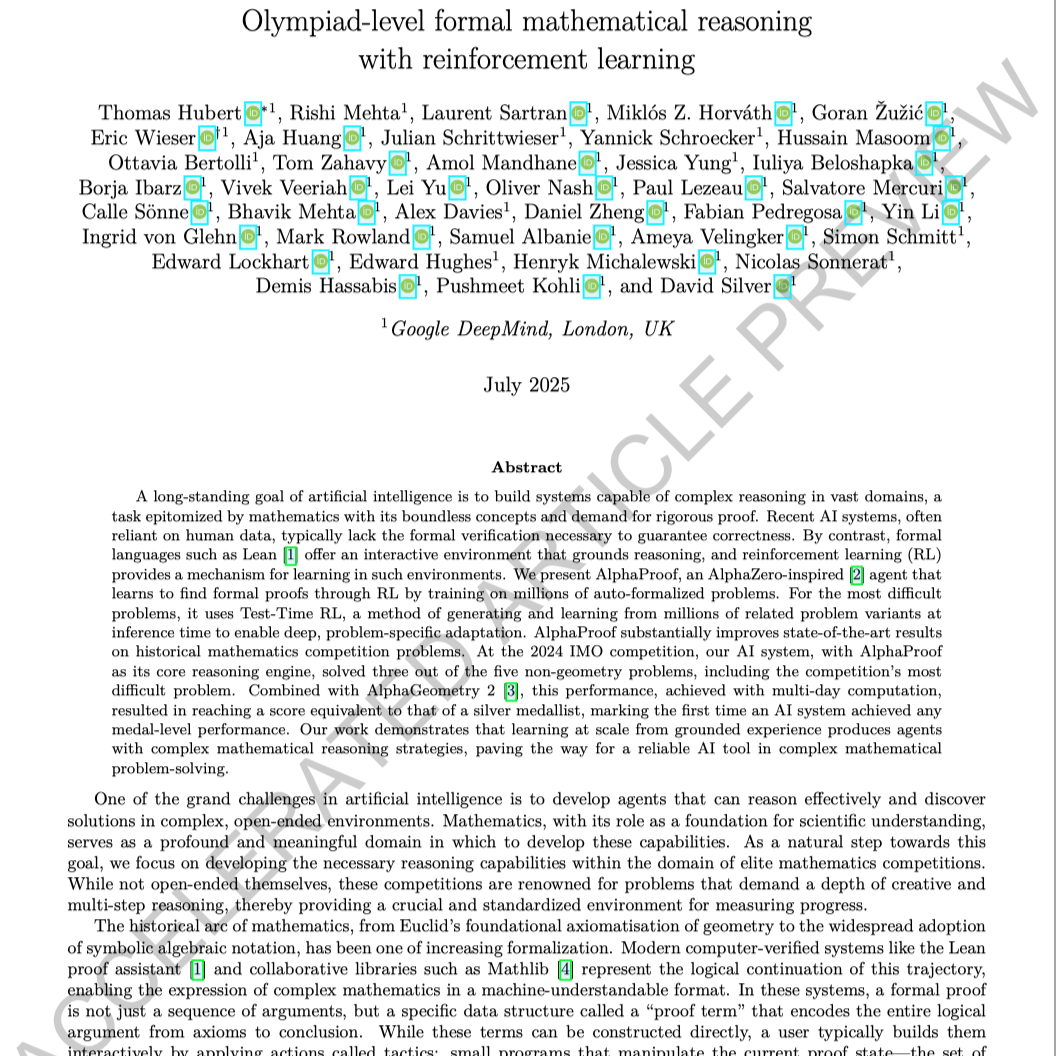
Olympiad-level formal mathematical reasoning with reinforcement learning
Summary
人工智能的一个长期目标,是构建能够在广阔领域中进行复杂推理的系统,而数学正是这一目标的典型代表:它拥有无穷无尽的概念,并且要求严格的形式化证明。近年来的 AI 系统往往依赖人工生成的数据,通常缺乏形式化验证,因此难以保证推理结果的正确性。相比之下,诸如 Lean¹ 这样的形式化语言提供了一个能够将推理过程严格锚定的交互式环境,而强化学习(RL)则为在此类环境中进行学习提供了有效机制。
我们提出了 AlphaProof,一个受 AlphaZero² 启发的智能体,通过在数百万道自动形式化的问题上进行强化学习训练,学会寻找形式化证明。对于最困难的问题,AlphaProof 采用了一种称为“测试时强化学习”(Test-Time RL)的方法:在推理阶段生成并从数百万个相关问题变体中进行学习,从而实现深度的、针对具体问题的自适应能力。
AlphaProof 在历史数学竞赛题目上显著超越了当前最先进的方法。在 2024 年国际数学奥林匹克(IMO)竞赛中,以…
The skinny
The skinny isn't ready yet — notes appear once the transcript is processed.