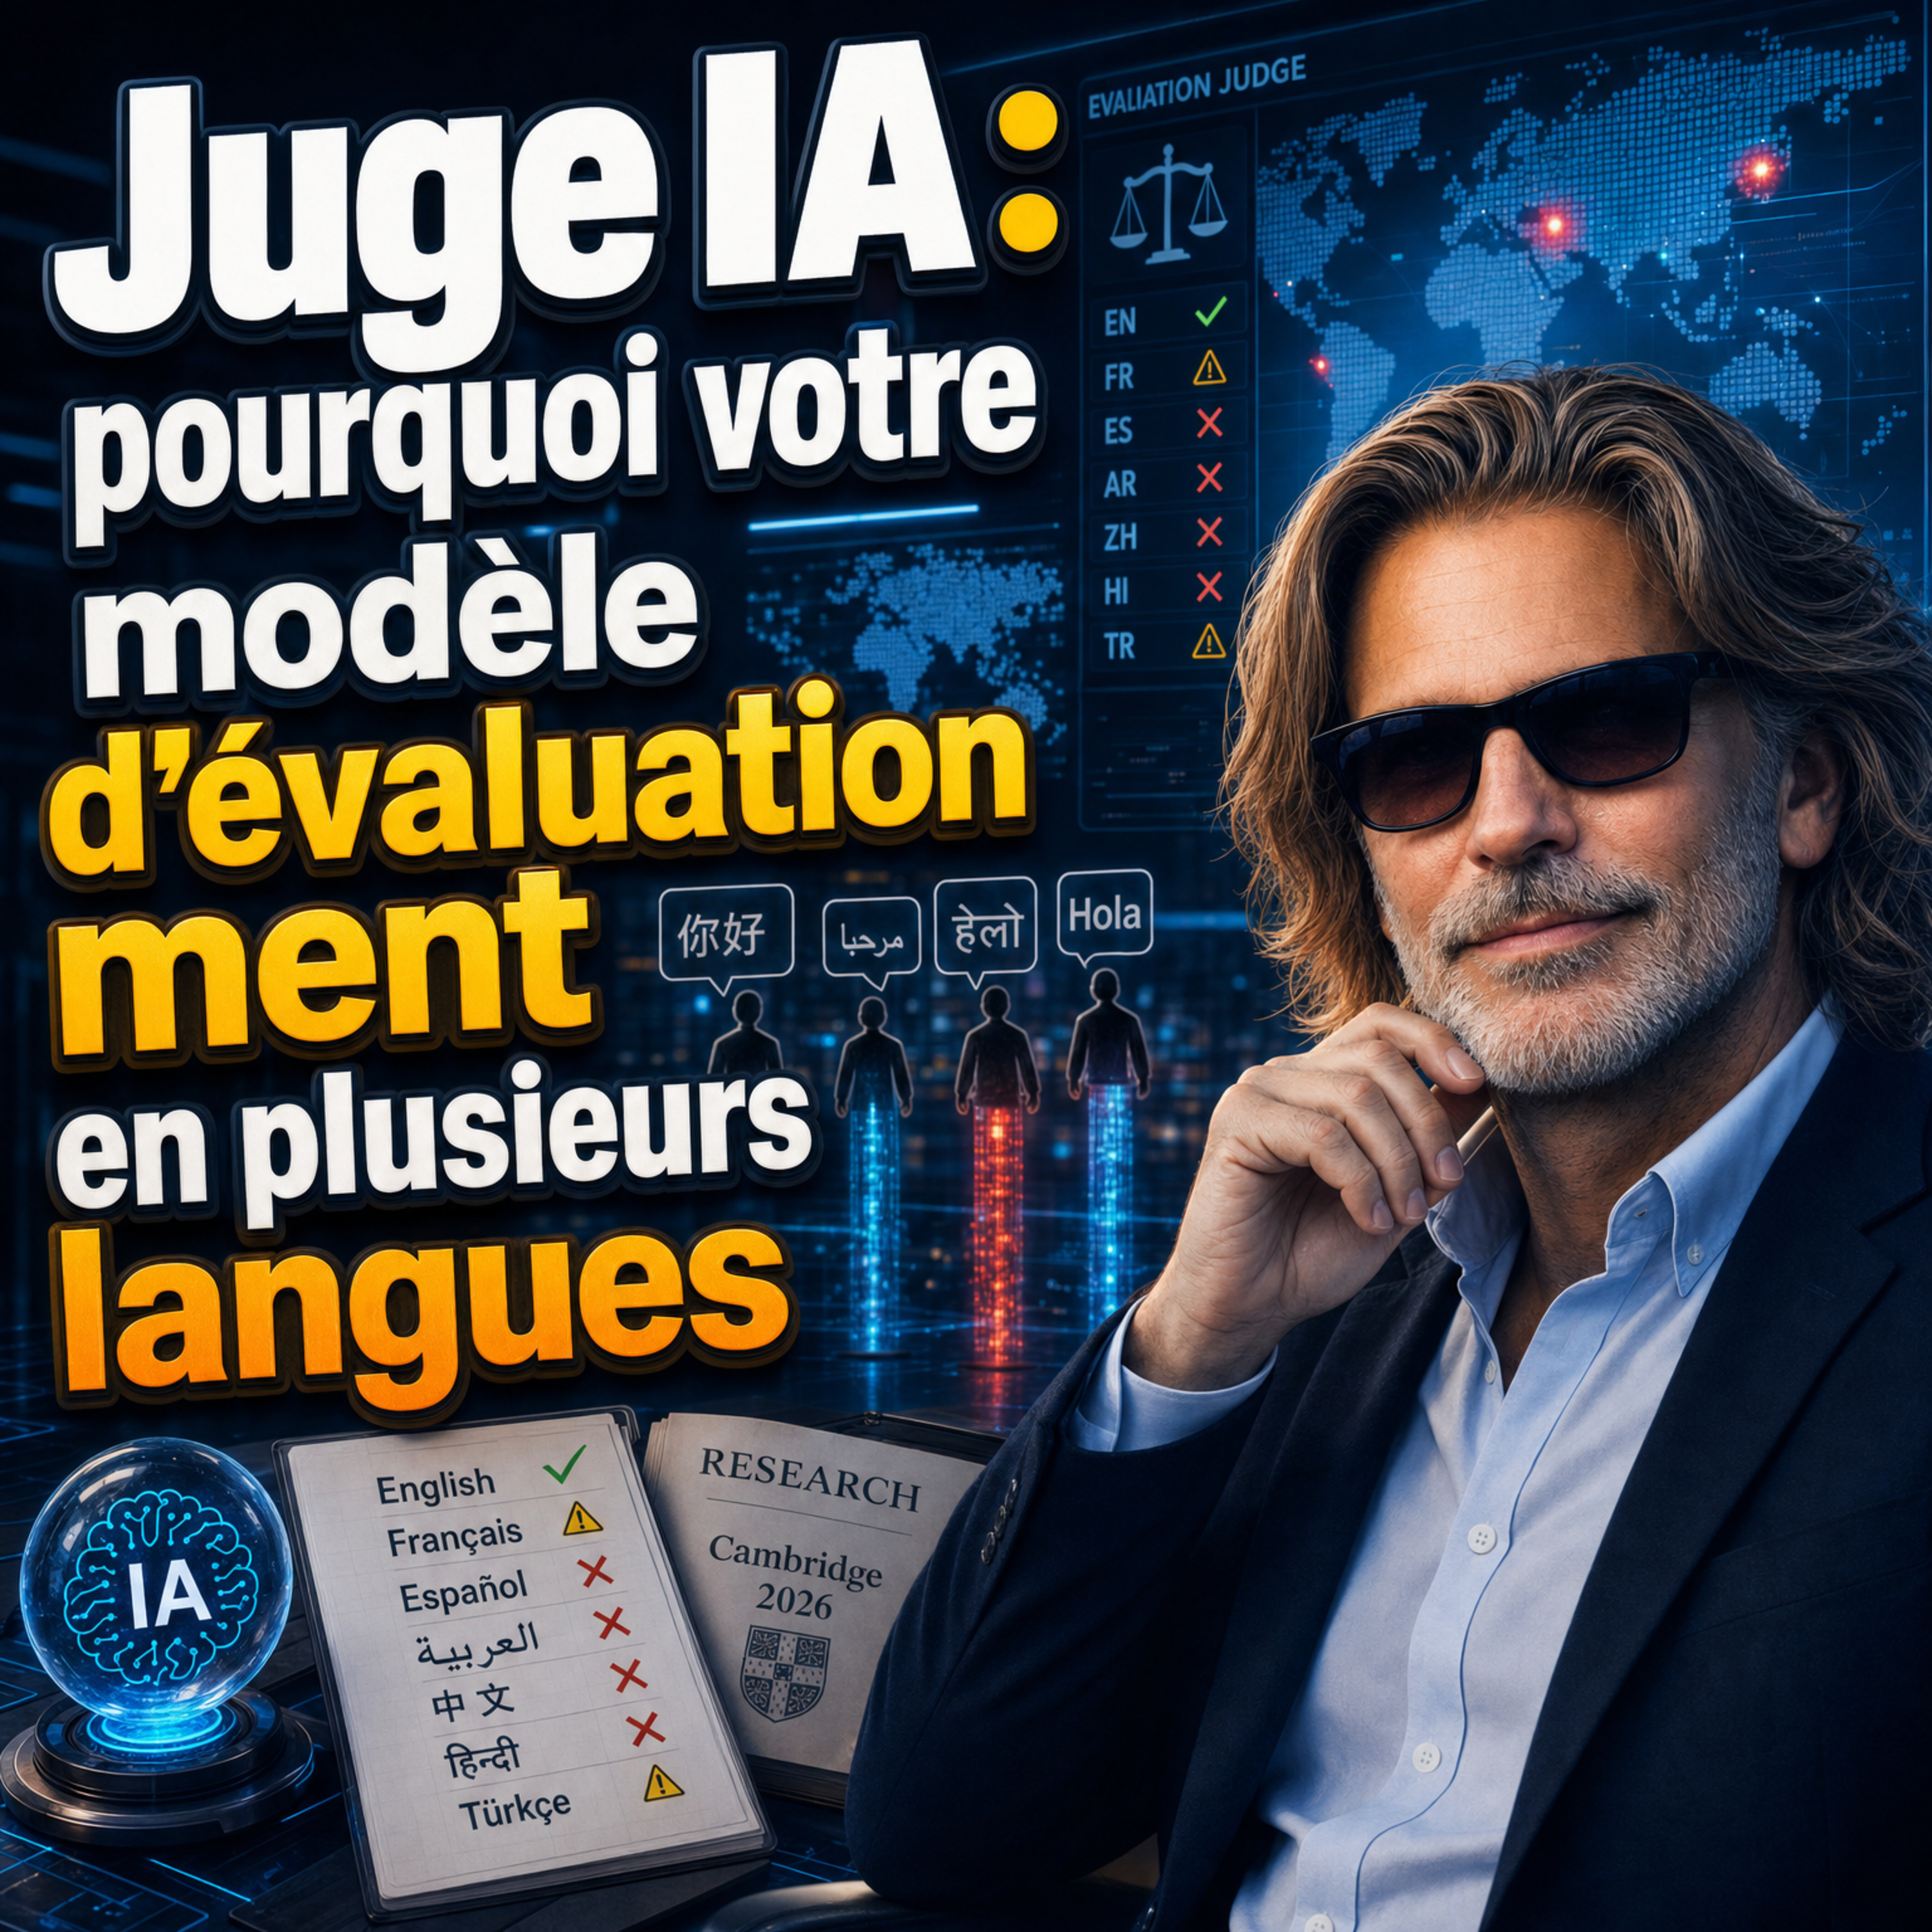
Juge IA : pourquoi votre modèle d'évaluation ment en plusieurs langues
Votre juge LLM affiche une précision de 90 % et pourtant, ses filtres de sécurité laissent passer d'immenses disparités d'une langue à l'autre. En nous appuyant sur une étude de Cambridge publiée en juillet 2026, nous révélons pourquoi les IA évaluent de manière biaisée selon la langue et comment sortir du piège d'un arbitrage universel illusoire.
#business #meta-volatile #multilingue #trustandsafety #securiteIA
The skinny
The skinny isn't ready yet — notes appear once the transcript is processed.