【第607期】AlphaEval:生产环境下的AI智能体综合评估基准
Seventy3:借助NotebookLM的能力进行论文解读,专注人工智能、大模型、机器人算法、crypto方向,让大家跟着AI一起进步。
如果你想要解读自己的论文,获得更多曝光度。请联系小助手微信:seventy3_podcast 加群。
合作邮箱:zhiwudazhanjiangshi#gmail.com
今天的主题是:
AlphaEval: Evaluating Agents in Production
Summary
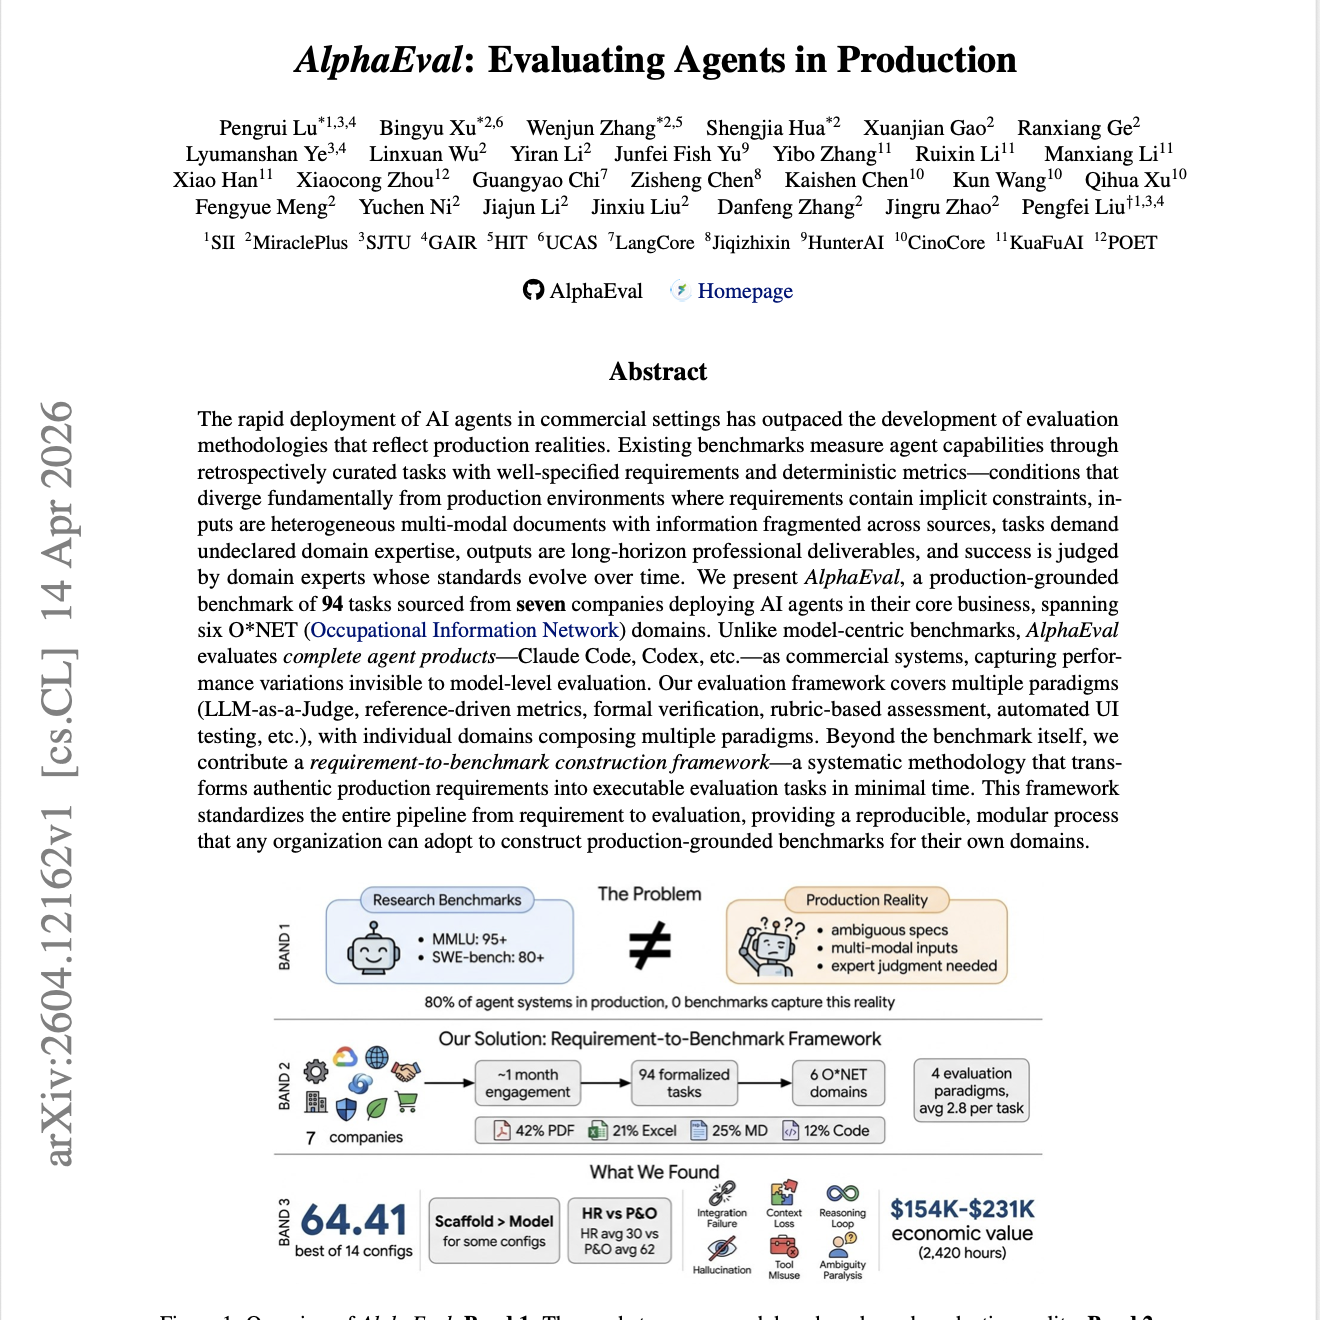
AI 智能体在商业场景中的快速部署,已经超过了能够真实反映生产环境的评测方法的发展速度。现有基准测试通常通过事后整理(retrospectively curated)的任务来衡量智能体能力,这些任务具有明确规定的需求和确定性的评价指标——而这些条件与真实生产环境存在根本差异。
在实际生产环境中:
需求往往包含隐含约束;
输入是异构的多模态文档,且信息分散于多个来源;
任务需要未被显式声明的领域专业知识;
输出通常是长周期的专业交付物;
成功标准由领域专家判定,并且这些标准会随时间变化。
我们提出了 AlphaEval,一个基于真实生产环境构建的基准测试集,包含来自七家在核心业务中部署 AI 智能体的公司的 94 项任务,覆盖六个 O*NET(职业信息网络)领域。
与以模型为中心的基准测试不同,AlphaEval 评估的是完整的智能体产品——例如 Claude…
The skinny
The skinny isn't ready yet — notes appear once the transcript is processed.