【第724期】ReOPD:多轮交互的重播前缀在线策略蒸馏
今天的这篇的主题是: Multi-Turn On-Policy Distillation with Prefix Replay
Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。
如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。
联系小助手微信:eccstartup(加群/投稿论文)
Summary
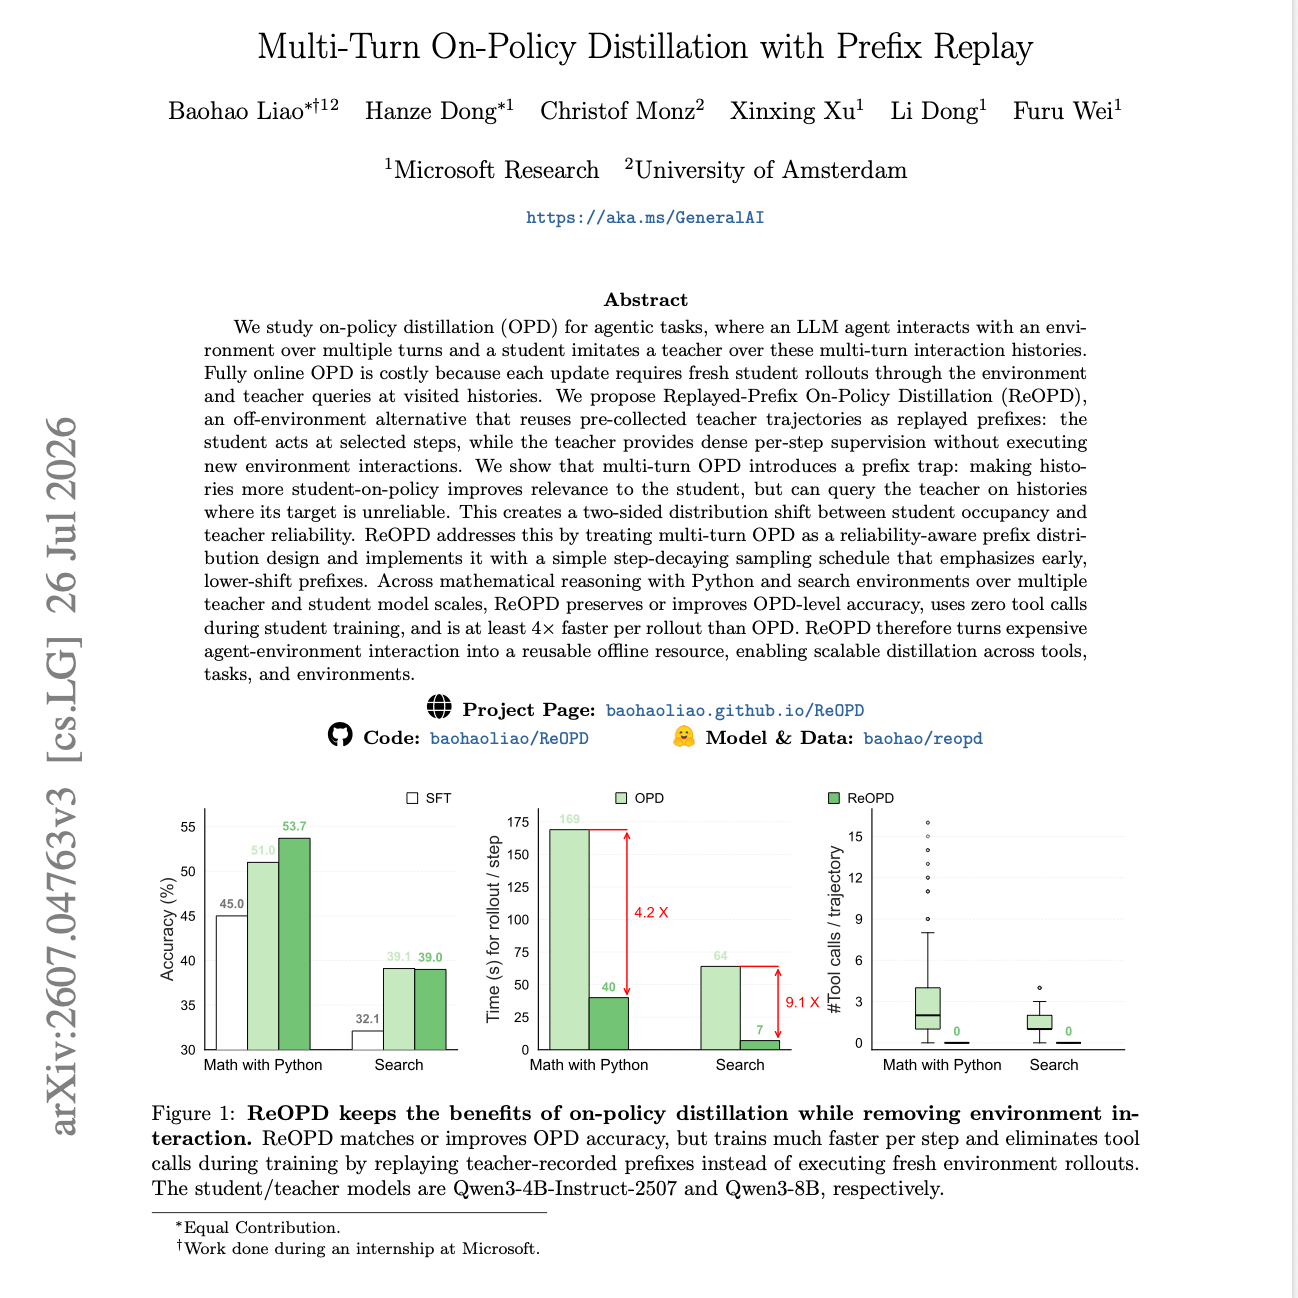
我们研究了针对 Agent 任务的在线策略蒸馏(On-policy Distillation, OPD)。在这些任务中,大型语言模型(LLM)Agent 跨越多个轮次与环境进行交互,学生模型在这些多轮交互历史中对教师模型进行模仿。完全在线的 OPD 成本极高,因为每一次更新都需要学生模型在环境中进行全新的采样(rollouts),并在所访问的历史节点处向教师模型发起查询。
我们提出了重放前缀在线策略蒸馏(Replayed-Prefix On-Policy Distillation…
The skinny
The skinny isn't ready yet — notes appear once the transcript is processed.