【第666期】MiniMax Sparse Attention-算力缩减28倍的MSA架构
Seventy3 是一档借助 NotebookLM 解读前沿论文的播客——不是念摘要,也不是泛泛而谈,而是让 AI 帮你把论文掰开揉碎,说人话。我们蹲在人工智能、大模型、机器人算法、crypto 这几个领域,每期挑一篇值得关注的工作,用对话的方式聊给你听。你可以在通勤路上听,做实验的时候听,也可以当背景音放着,让新知识自然地长进脑子里。
如果你正在做有意思的研究,想让更多人看到——不管你是博士生、独立研究者还是实验室的博士后——把论文发给我们,我们帮你用 AI 做一期深度解读,让你的工作被更多同路人发现。
联系小助手微信:seventy3_podcast(加群/投稿论文)
今天的这篇的主题是:
MiniMax Sparse Attention
Summary
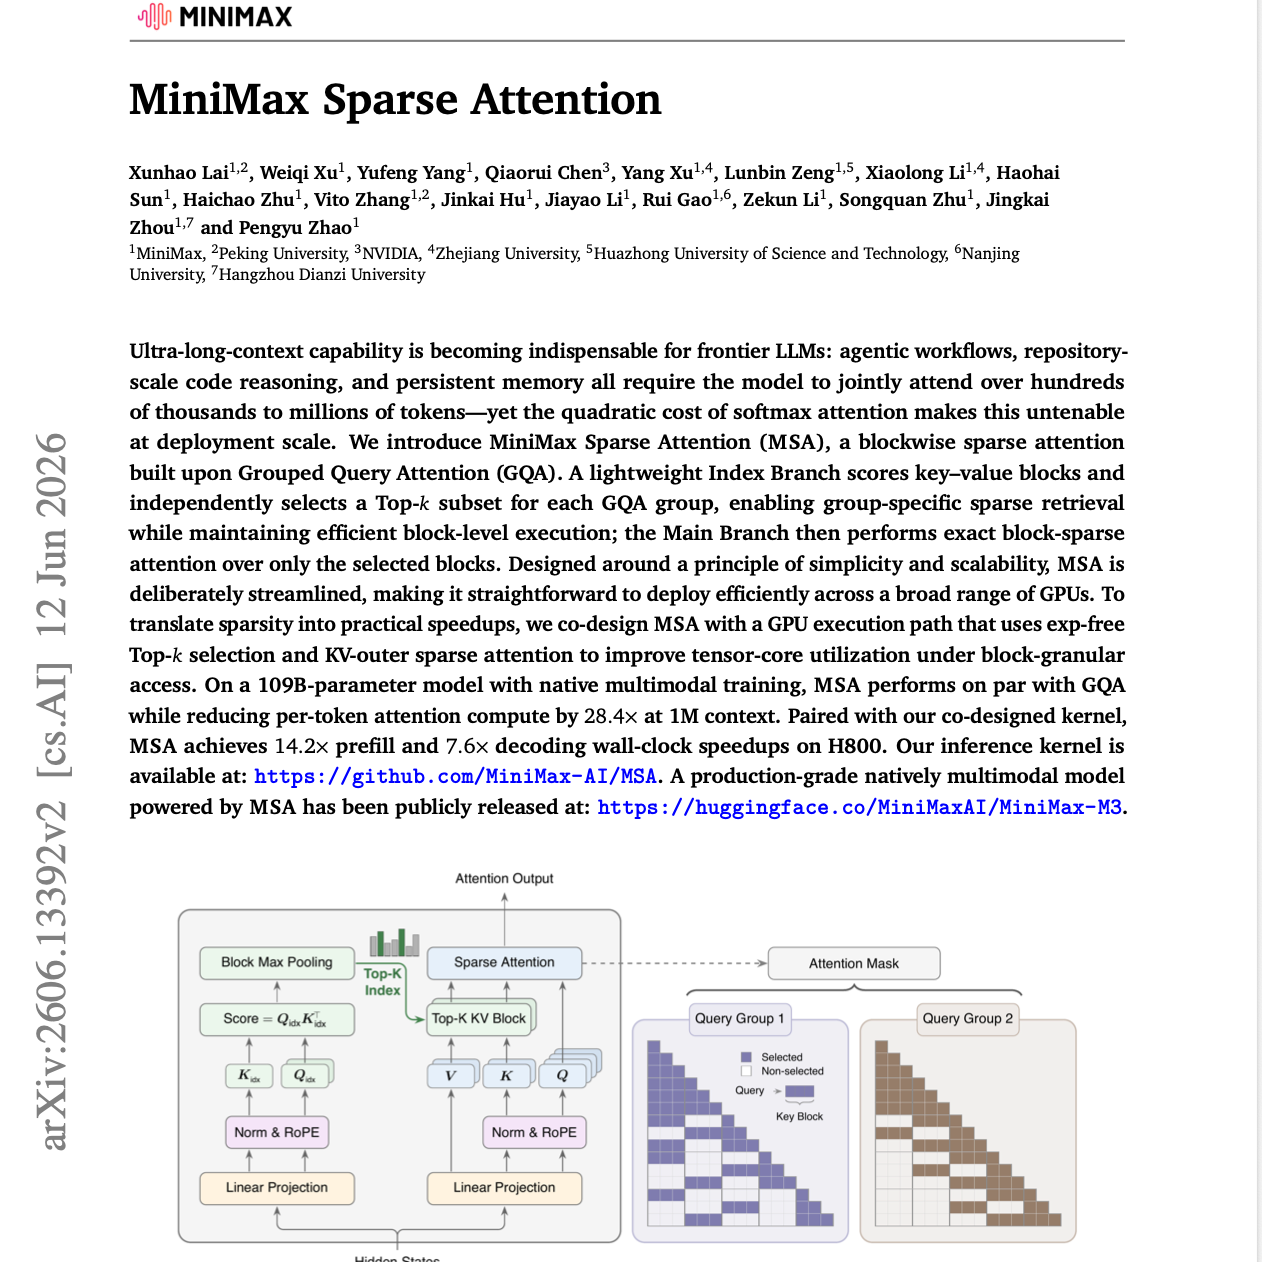
超长上下文能力正在成为前沿大语言模型(LLM)不可或缺的能力:智能体工作流(agentic workflows)、代码仓库级别的代码推理(repository-scale code reasoning)以及持久化记忆(persistent memory)都要求模型能够联合关注数十万到数百万级别的 token。然而,softmax 注意力机制的二次计算复杂度,使得这种能力在实际部署规模下难以实现。
我们提出了 MiniMax 稀疏注意力(MiniMax Sparse Attention…
The skinny
The skinny isn't ready yet — notes appear once the transcript is processed.