【第495期】Self-play SWE-RL:基于自我博弈的软件工程智能体强化学习
Seventy3:借助NotebookLM的能力进行论文解读,专注人工智能、大模型、机器人算法、crypto方向,让大家跟着AI一起进步。
今天的主题是:
Toward Training Superintelligent Software Agents through Self-Play SWE-RL
Summary
尽管当前基于大语言模型(LLMs)和智能体强化学习(agentic RL)的软件智能体能够提升程序员的生产力,但它们的训练数据(如 GitHub Issues 与 Pull Requests)和环境(如 pass-to-pass 与 fail-to-pass 测试)高度依赖人工知识或人工维护,这构成了迈向超级智能的根本障碍。
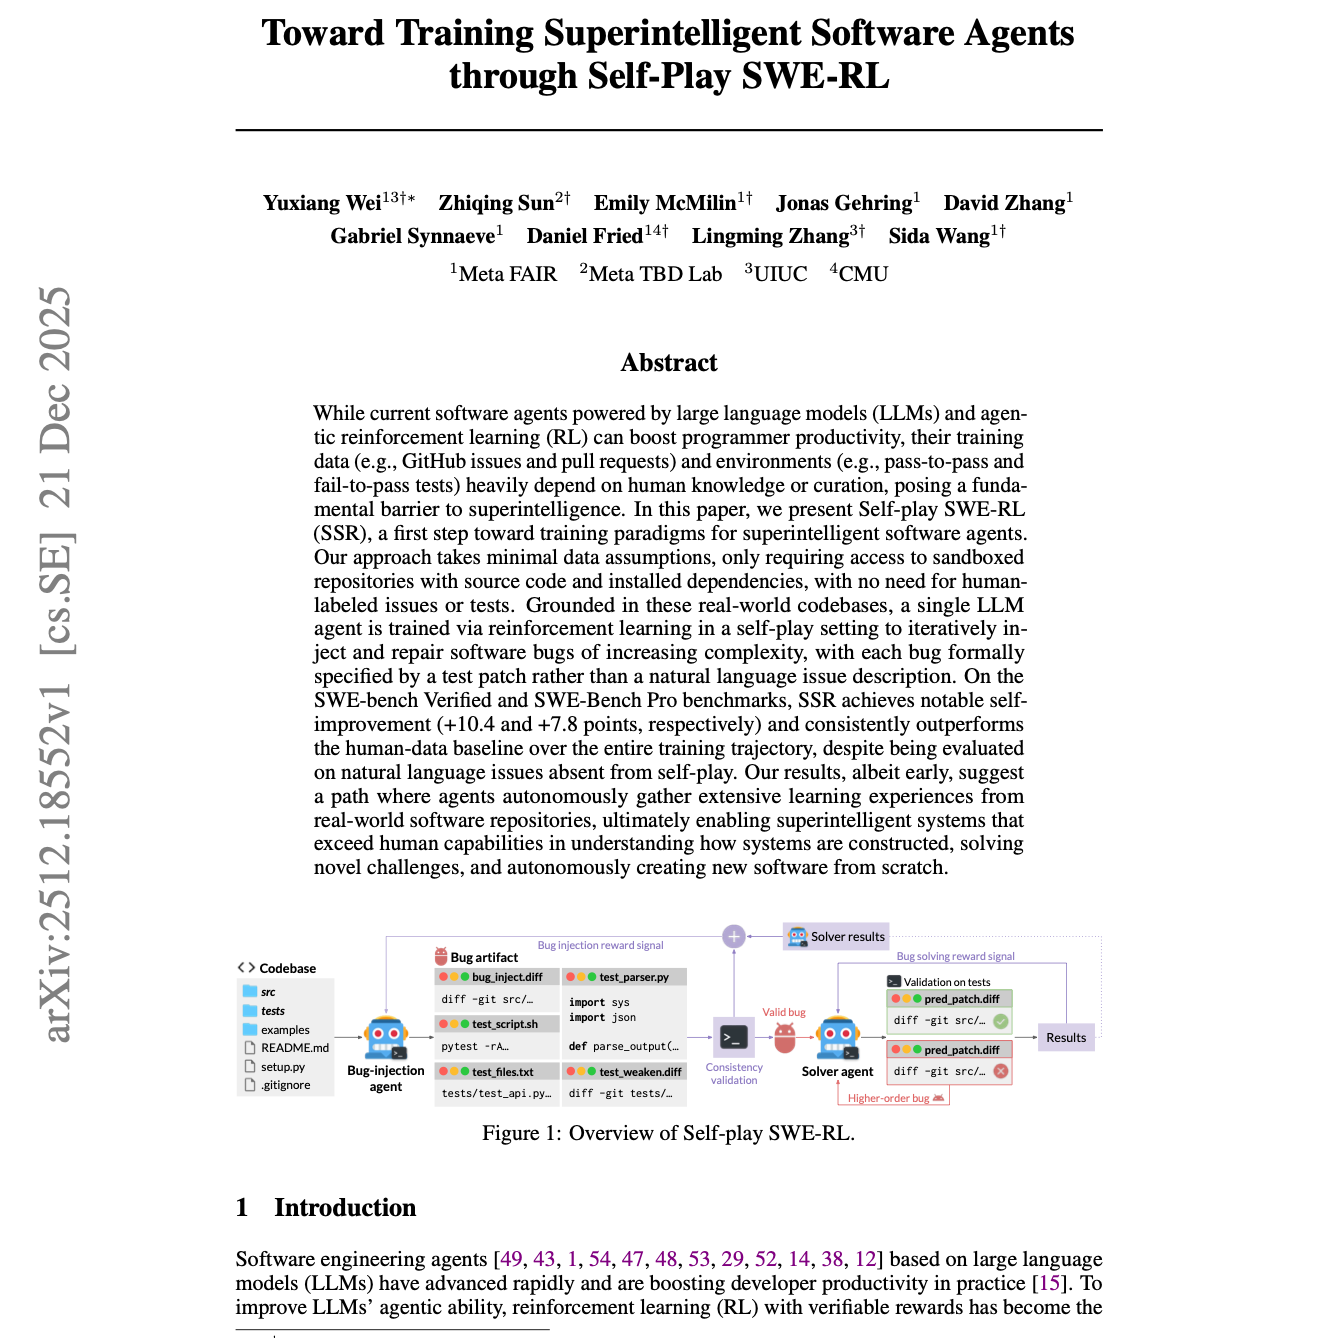
本文提出 Self-play SWE-RL(SSR),作为面向超级智能软件智能体训练范式的第一步。该方法对数据几乎没有假设,仅需要访问带有源代码和已安装依赖的沙箱仓库,无需人工标注的 Issues 或测试用例。基于这些真实代码库,我们在**自我对弈(self-play)的设置下,通过强化学习训练单智能体 LLM,迭代地注入并修复日益复杂的软件缺陷,每个缺陷由测试补丁(test patch)**形式的正式规范定义,而非自然语言描述的 Issue。
在 SWE-Bench Verified 与 SWE-Bench Pro 基准上,SSR…
The skinny
The skinny isn't ready yet — notes appear once the transcript is processed.