【第612期】DeepSeek-V4:高效百万长度上下文智能语言模型
Seventy3:借助NotebookLM的能力进行论文解读,专注人工智能、大模型、机器人算法、crypto方向,让大家跟着AI一起进步。
如果你想要解读自己的论文,获得更多曝光度。请联系小助手微信:seventy3_podcast 加群。
合作邮箱:zhiwudazhanjiangshi#gmail.com
今天的主题是:
DeepSeek-V4: Towards Highly Efficient Million-Token Context Intelligence
Summary
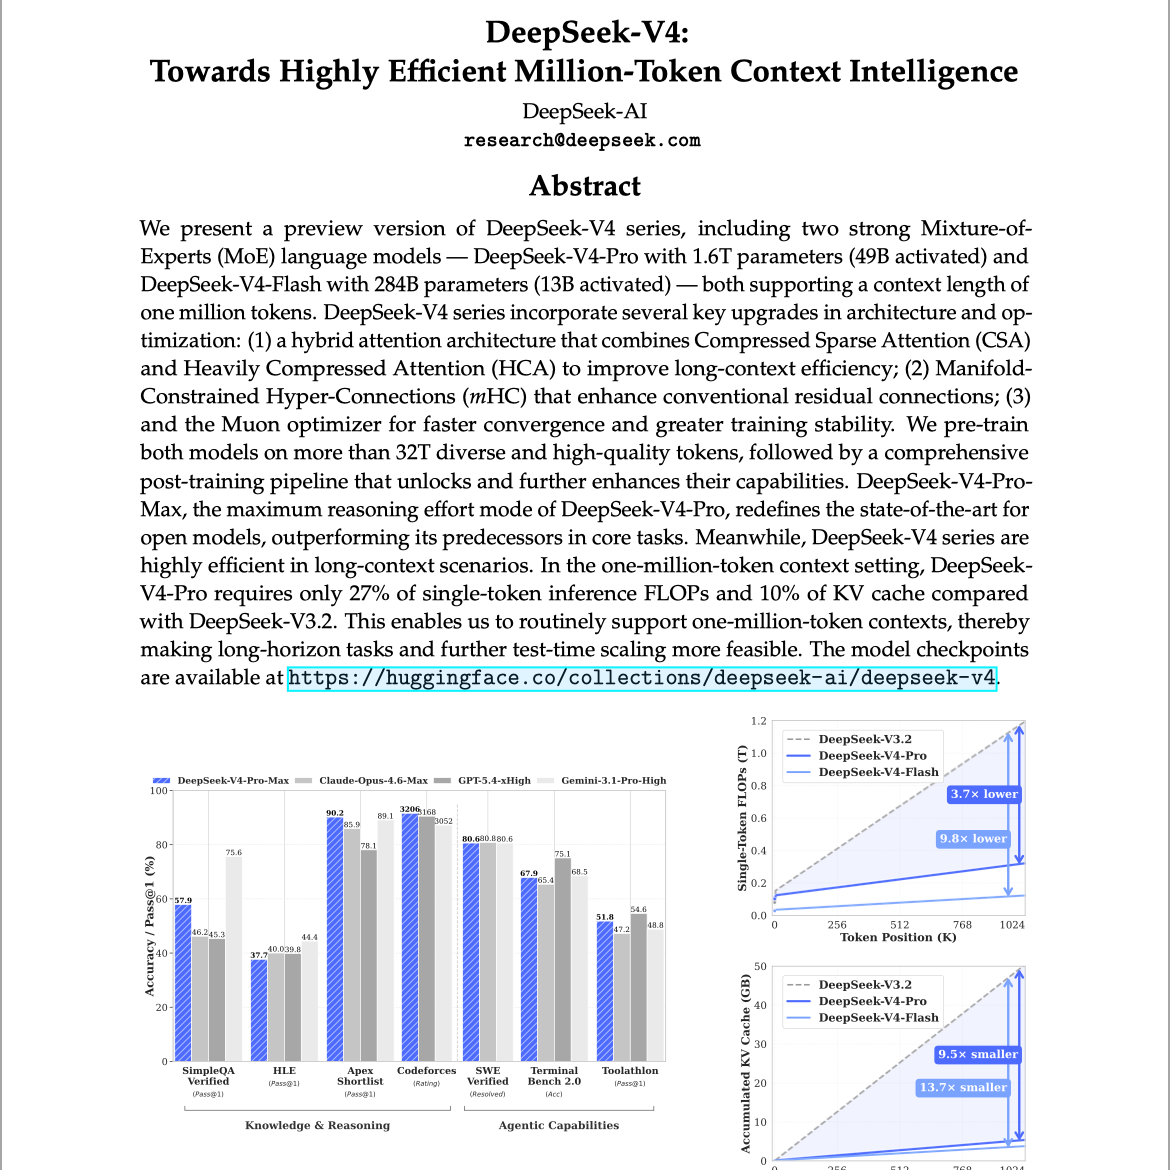
我们提出 DeepSeek-V4 系列的预览版本,包括两款强大的混合专家(Mixture-of-Experts, MoE)语言模型:
DeepSeek-V4-Pro:1.6T 参数(其中 49B 参数在推理时激活)
DeepSeek-V4-Flash:284B 参数(其中 13B 参数在推理时激活)
两者均支持高达 100 万 token 的上下文长度。
DeepSeek-V4 系列在架构与优化方面包含若干关键升级:
混合注意力架构(hybrid attention architecture)
结合压缩稀疏注意力(Compressed Sparse Attention, CSA)与高度压缩注意力(Heavily Compressed Attention, HCA),以提升长上下文效率;…
The skinny
The skinny isn't ready yet — notes appear once the transcript is processed.