【第171期】DivPO:Diverse Preference Optimization
Seventy3: 用NotebookLM将论文生成播客,让大家跟着AI一起进步。
今天的主题是:
Diverse Preference Optimization
Summary
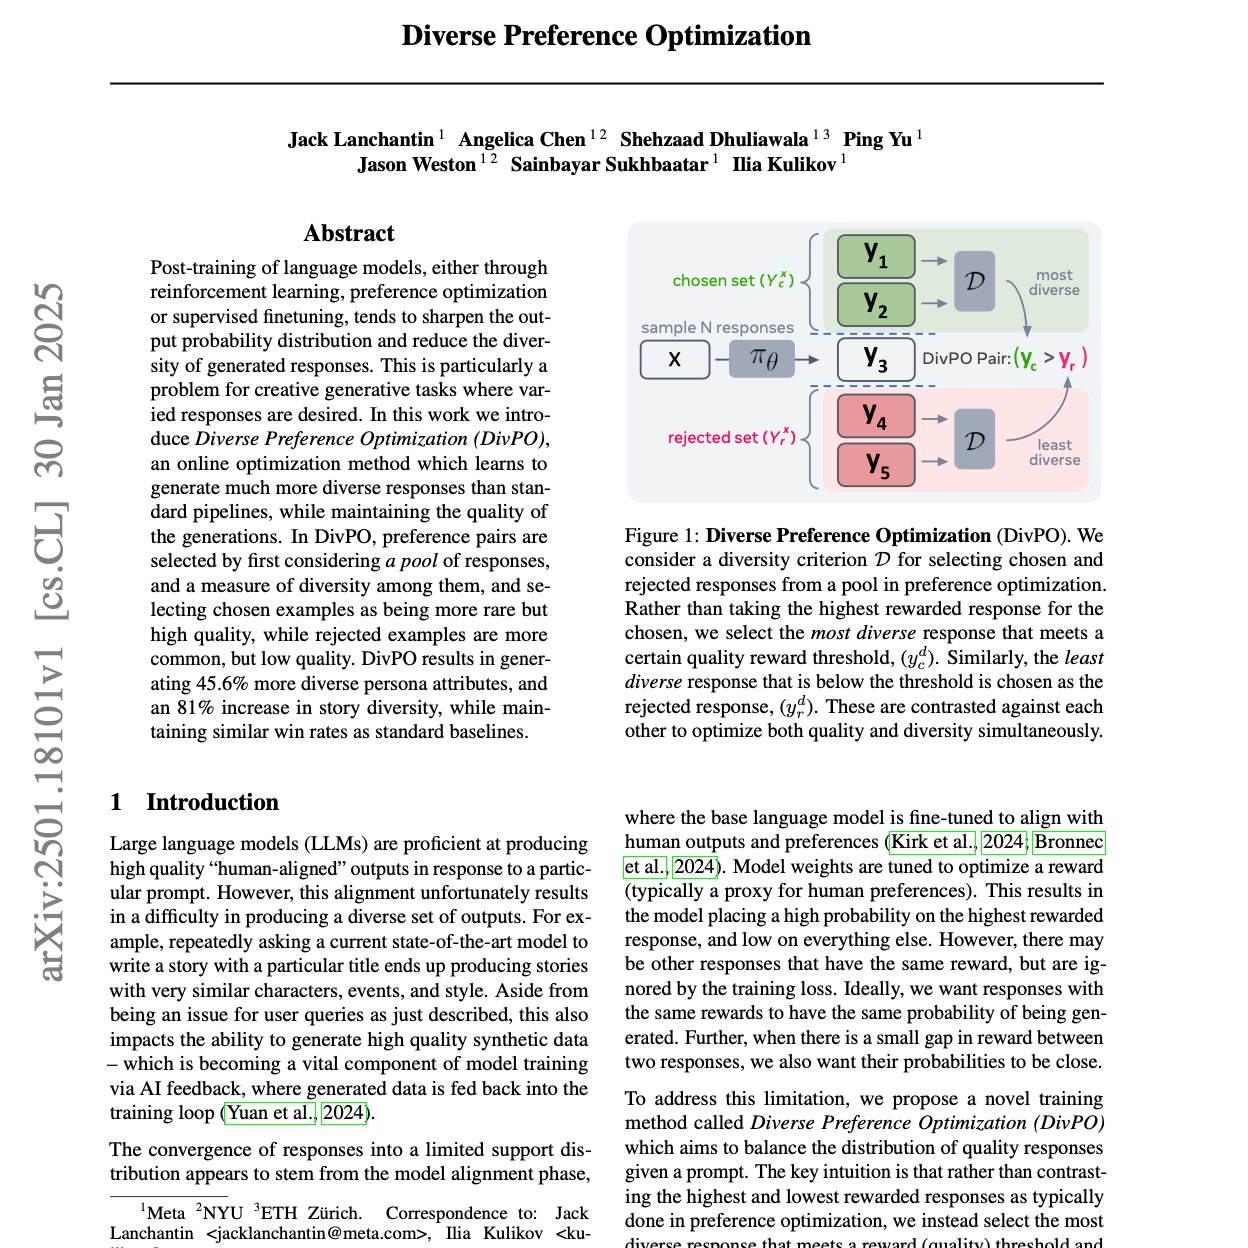
The research introduces Diverse Preference Optimization (DivPO), a novel training method designed to enhance the diversity of language model outputs while maintaining quality. Current optimization techniques often lead to a reduction in diversity, especially in creative tasks. DivPO addresses this by selecting preference pairs based on both quality and diversity, contrasting diverse, high-reward responses with less diverse, lower-reward ones. The method demonstrates significant improvements in diversity…
The skinny
The skinny isn't ready yet — notes appear once the transcript is processed.