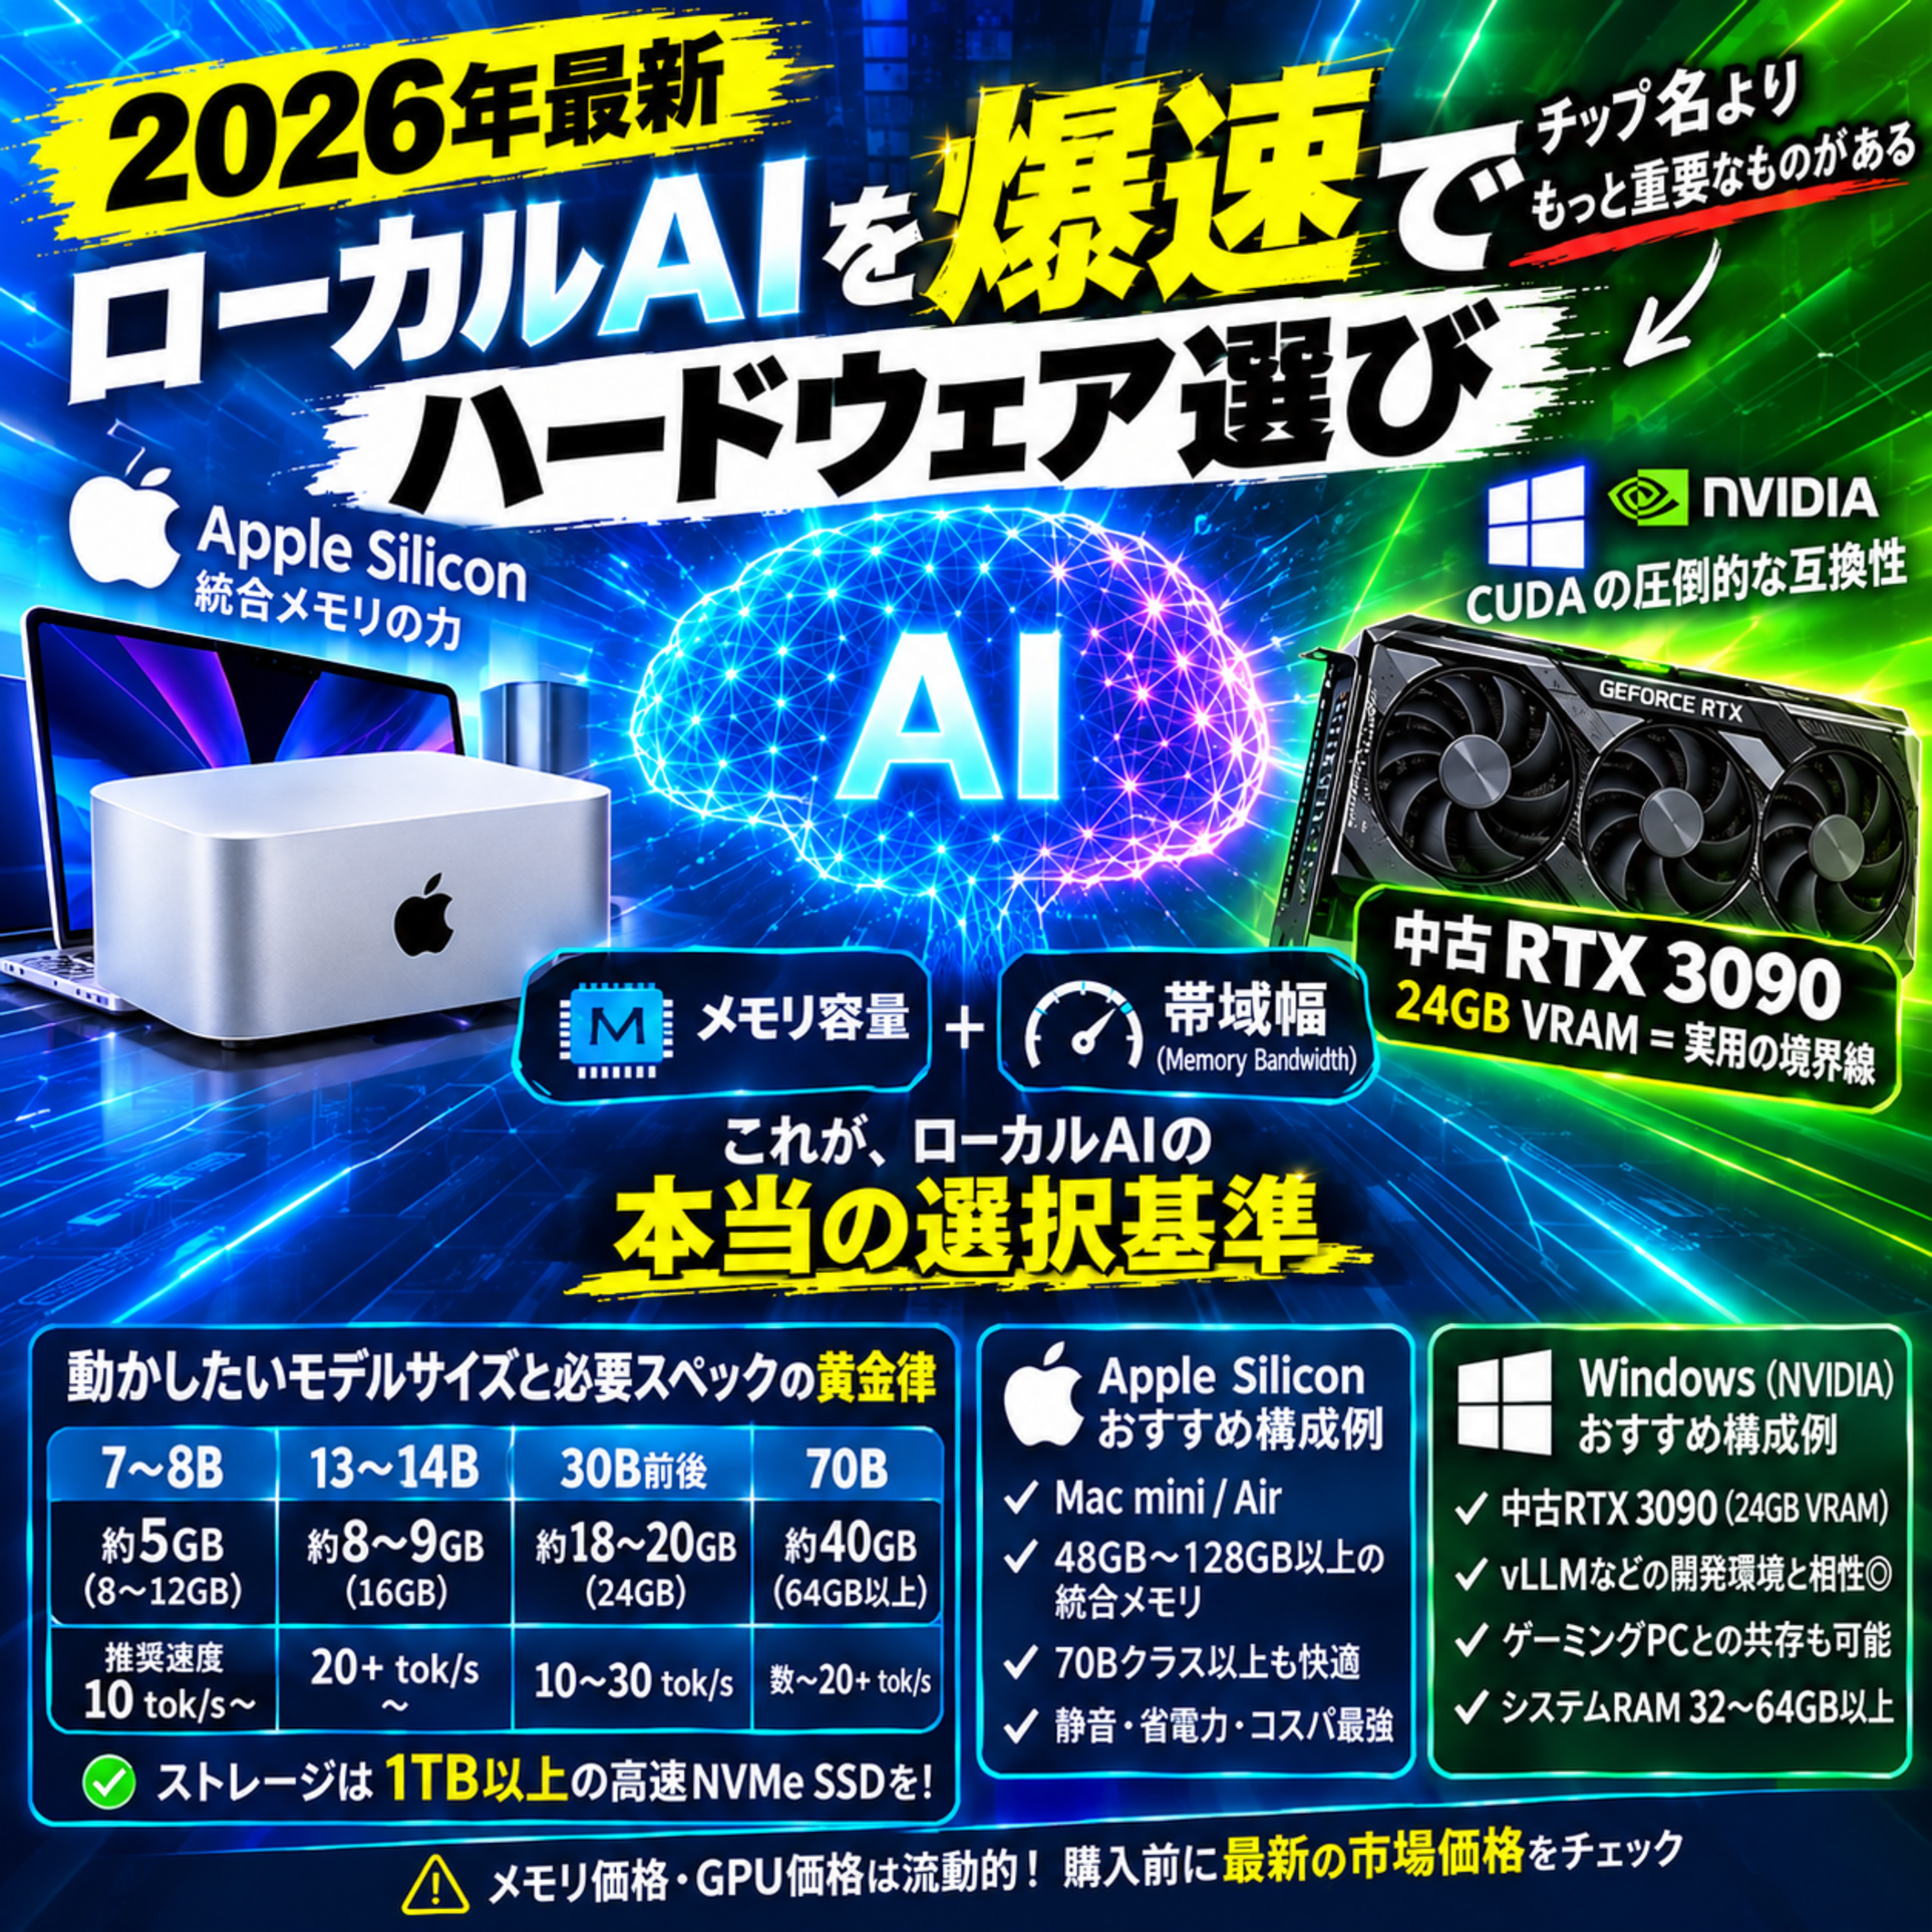
ローカルAIを爆速で動かすハードウェア選び
【2026年最新】自分だけのAIアシスタントをプライバシーの心配なく、レスポンスの遅延もなしに手元で自由に走らせたい——そう考えたとき、誰もが最初に直面するのがこの疑問です。そして多くの人が、プロセッサの最新世代名や最高クロック周波数、あるいはグラフィックボードの型番の大きさに目を奪われてしまいます。
しかし、ここには専門家でも陥りがちな「スペックの罠」が潜んでいます。2026年現在、ローカルAIの処理速度と実行可能性を本質的に支配しているのは、プロセッサの演算性能そのものではありません。本稿では、最新のハードウェアトレンドと技術的背景を紐解きながら、AIを爆速で動かすための真の選択基準を明かしていきます。
なぜ、最新のハイエンドプロセッサを積んだPCであっても、AIの動作が重縮してしまうのでしょうか。その秘密は、LLMの推論(Inference)処理が持つ特殊な計算構造にあります。
一般的に、ローカル環境でLLMを運用する際は「Q4_K_M」などに代表される4ビット量子化モデルを利用するのが標準的です。モデルデータはメモリ上に保持されますが、LLMの自己回帰生成(1トークンずつ順番に文字を出力する処理)においては、**「たった1トークンを出力するために、モデルの全重みデータを毎回メモリから計算コアへ読み出さなければならない」**という決定的な特徴があります。…
The skinny
The skinny isn't ready yet — notes appear once the transcript is processed.